Amazon ECS Fargate上のServerless MCP:エージェント向けデータレイク接続をメタデータ駆動に
エージェントごとの接続実装を、共有MCPゲートウェイへ集約
AmazonのNorth America Sort Center(NASC)ネットワークを支援するチームは、計画担当者が運用データへ対話的にアクセスできるよう、Amazon ECSとAWS Fargate上にサーバーレスMCPサーバーを構築した。狙いは、AIエージェントごとにデータベース接続、SQL生成、スキーマ理解、アクセス制御を実装する従来方式を改め、複数のエージェントやアプリケーションが共有できるデータアクセス層を設けることだ。
従来の構成では、データセットが増えるたびに個別のツールコードやクエリ検証が必要になり、スキーマ変更時にも複数のエージェントを修正する必要があった。権限管理や監査も分散し、新しいテーブルの導入に通常数日を要していた。これに対し、同サーバーはデータレイクとエージェントの間に共通ゲートウェイを置き、MCP互換クライアントに標準化されたツールを提供する。
設計上の要件は、データセット追加をコード変更なしで行えること、エージェントに依存しないツールインターフェース、MCPサーバー層での一元的な権限制御、そして突発的なAIワークロードに対応する伸縮性の4点である。各レイヤーを独立して展開・拡張できるよう、クライアント、MCPサーバー、ツール、ナレッジベース更新の4層に分離している。
リクエスト経路とメタデータ駆動のSQL実行
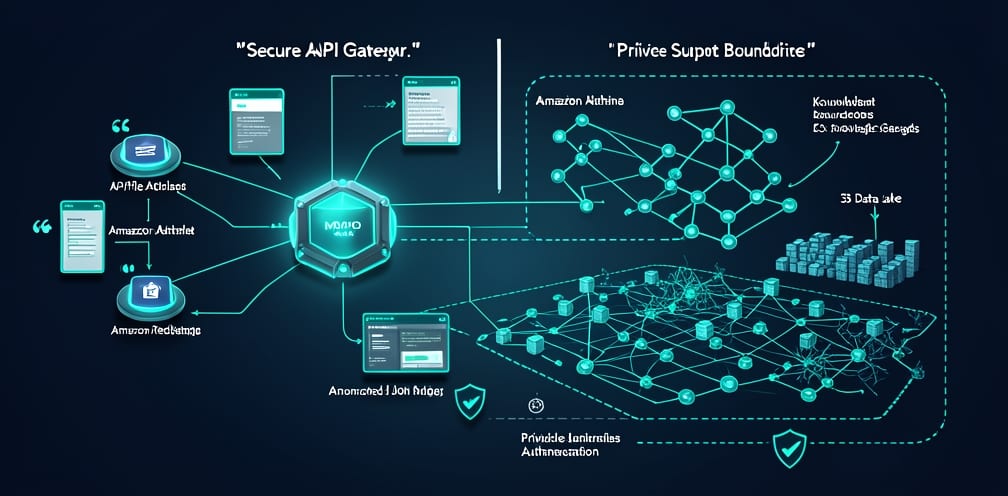
ユーザーのリクエストは、Amazon Route 53による名前解決後、HTTPSとAWS WAFを設定したパブリックサブネット上のApplication Load Balancerに到達する。クライアント層のECS FargateサービスはAmazon CognitoでJWTを認証し、セッション状態をAmazon DynamoDBに保存する。その後、内部Application Load Balancer経由で、プライベートサブネット内の別クラスターにあるMCPサーバーへ転送する。MCPサーバーはFastMCPでツールを登録し、Amazon Bedrockを使ってリクエスト分析、ツール選択、実行、応答生成を統括する。外部のMCP互換クライアントは、/mcpのJSON-RPCエンドポイントからツールを検出・呼び出せる。
データアクセスの中核は、テーブルのスキーマ、業務上の意味、テーブル間の関係を保持するメタデータカタログである。エージェントはクエリ時にカタログを参照するため、スキーマをコードに埋め込んだり、変更のたびにサーバーを再デプロイしたりする必要がない。新しいデータセットは、テーブル情報や列の説明、サンプル値、更新頻度などを記述したJSONファイルとして追加する。パイプラインはメタデータを取り込み、Amazon Titan Text Embeddingsでベクトル化したうえでAmazon Bedrock Knowledge Basesにインデックスする。次回のパイプライン同期後には、接続済みエージェントからそのデータセットを検索できる。
実行時には、エージェントがまずカタログから候補スキーマを検索し、列の意味やサンプル値、エンジン固有のヒントをもとにSQLを生成する。SQLはAthena互換性を検証・補正してから実行され、結果は自然言語の応答に整形される。たとえば、文字列リテラルとtimestamp列の比較でdate()を使うといったヒントを、テーブルの業務説明に持たせられる。サンプル値も、warehouse_idが「East region facility」のような名称ではなくFC-EAST-07形式であることをモデルに伝え、WHERE句の生成を助ける。
業務コンテキストのマッピングは、検索対象を特定のテーブル群に絞るための任意設定だ。たとえば、配送関連の問い合わせを配送指標に関係するテーブルへ限定できる。範囲を絞ることで検索時のノイズを抑え、SQL生成の精度向上を狙う。記事のテストでは、このスコープ設定を含むエンドツーエンドの処理時間は15〜20秒だった。
ツールは、Amazon AthenaおよびAmazon RedshiftによるSQLクエリ、Knowledge Basesによる文書・メタデータ検索、運用ポリシー検索を提供する。構造化データと非構造化データを一つのリクエストで組み合わせ、Athenaで返品率を集計しながら、Knowledge Basesでその要因に関する分析文書を検索する、といった応答も可能となる。
一元的なセキュリティとワークロード別スケーリング
セキュリティは単一の境界に依存せず、ネットワーク、認証、ツール実行の各層で制御される。MCPサーバーはプライベートサブネットの内部Application Load Balancerの背後に配置され、インターネットから直接到達できない。公開側のロードバランサーはAWS WAFを通し、クライアント層ではCognitoがユーザーを認証する。さらにAthenaツールはSELECT専用クエリを強制し、書き込み操作をデータレイクに到達する前に拒否する。全ツール呼び出しは構造化JSON形式でAmazon CloudWatchに記録され、エージェントやアプリケーションを横断した監査ポイントとなる。
Amazon Bedrock Guardrailsはすべてのモデル対話に適用され、有害な内容のフィルタリング、グラウンディング確認、プロンプトインジェクションの抑制を支援する設計だ。共通のMCPサーバー層でこの制御を適用することで、異なるクライアントが同一のツールを利用しても、共通の安全ポリシーを適用できる。なお、記事が示すのはGuardrailsの設計目的と構成であり、攻撃を完全に防止する保証ではない。
会話履歴はDynamoDBに保持し、Fargateタスク自体はステートレスにする。これにより、タスクの交換やスケール変更による会話状態の喪失を避けられる。スケーリング方式はレイヤーごとに異なり、クライアント層はCPU使用率50%をしきい値とするECS Service Auto Scaling、MCPサーバー層はCPU・メモリ使用率に基づくECS Service Auto Scalingを使う。Athenaはクエリ同時実行数に応じたサーバーレスの自動スケーリング、Bedrockは推論リクエストに対するマネージドサービスのスケーリングを利用する。FargateによりEC2インスタンスの管理を不要にし、単一クエリから数百件の同時クエリまで、基盤設定を変えずに処理する構成を目指す。
開発者・エンジニア視点での考察
-
データセットのオンボーディングを「設定の品質管理」として設計する。
JSON化によって実装コードは減る一方、スキーマ説明、列の意味、サンプル値、SQL方言ヒントの品質が、検索とクエリ生成の精度を左右する。メタデータのスキーマ検証、必須フィールドのチェック、変更差分のレビューをパイプラインに組み込み、ファイルを単なる入力ではなく運用対象のインターフェースとして扱うべきだ。 -
コンテキストマッピングを、精度と対象範囲を管理する仕組みとして扱う。
業務コンテキストによるテーブル絞り込みは検索ノイズを減らすが、誤ったマッピングは必要なデータを候補から外す可能性もある。コンテキストごとに対象テーブルと説明をレビューできるようにし、スコープ指定あり・なしの検索結果やSQL生成の失敗を観測する設計が有効である。利便性だけでなく、どの業務領域のデータを検索対象にしているかを明示することにもつながる。 -
中央ゲートウェイの制御を、最小権限と監査の起点にする。
共通のアクセス経路はポリシーの一貫性と監査性を高めるが、記事で示されているSELECT専用制御は書き込みを防ぐものであり、列単位の機密データ制御とは別の課題である。今後の計画として示された、権限グループごとに制限列を定義しSQL生成から除外する機能を実装する際は、プロンプトへの指示だけに依存せず、ツール層での検証とCloudWatch上の呼び出し記録を組み合わせる必要がある。失敗クエリや低信頼度の結果から列説明・クエリヒントの改善案を導くフィードバックループも、メタデータ品質の継続的改善に役立つ。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。