Amazon Bedrock Data AutomationによるサーバーレスPII秘匿化パイプラインの構築
PII秘匿化の必要性とAmazon Bedrock Data Automationの役割
個人情報(PII)の保護は、データプライバシー規制の強化に伴い、企業にとって最優先事項となっています。顧客データ、医療記録、機密文書など、非構造化テキストデータに散在するPIIを手動で特定し、秘匿化することは、膨大な時間と労力を要し、エラーのリスクも伴います。Amazon Bedrock Data Automationは、この課題を解決するために設計されたサービスであり、機械学習を活用してPIIを自動的に検出し、秘匿化する機能を提供します。これにより、開発者はデータプライバシーとコンプライアンス要件を満たしながら、データ処理ワークフローを効率化できます。
サーバーレスアーキテクチャによるスケーラブルなPII秘匿化パイプライン
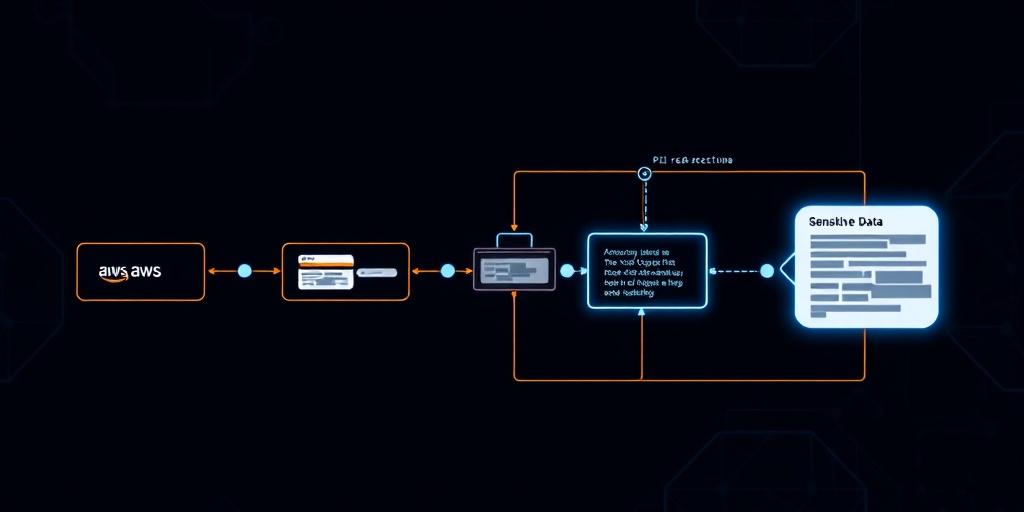
AWSは、Amazon Bedrock Data Automationを中心とした、堅牢でスケーラブルなサーバーレスPII秘匿化パイプラインの構築方法を提案しています。このアーキテクチャは、以下の主要なAWSサービスを組み合わせて構成されています。
- Amazon S3: 入力データ(秘匿化対象の非構造化テキストファイル)および出力データ(秘匿化されたテキストファイル)のストレージとして機能します。
- AWS Lambda: S3へのデータアップロードイベントをトリガーとして機能し、後続のワークフローを起動します。また、Step Functionsの実行開始やステータス更新にも利用されます。
- AWS Step Functions: 秘匿化プロセスのオーケストレーションを担い、PII検出、秘匿化、結果の保存といった一連のステップを調整します。これにより、複雑なワークフローも視覚的に管理し、エラー処理を容易にします。
- Amazon Bedrock Data Automation: このパイプラインの中核であり、実際にPIIの検出と秘匿化を実行するサービスです。設定されたルールに基づき、テキスト内のPII(氏名、住所、電話番号、メールアドレス、社会保障番号、クレジットカード番号など)を特定し、指定された方法(マスク、置換など)で処理します。
- Amazon DynamoDB: 秘匿化ジョブのメタデータやステータス情報を保存するために使用され、進捗状況の追跡や履歴管理を可能にします。
- Amazon EventBridge: Lambda関数とStep Functions間のイベント駆動型連携を可能にし、パイプラインの反応性と柔軟性を高めます。
このサーバーレス設計により、インフラストラクチャのプロビジョニングや管理の必要がなくなり、必要に応じて自動的にスケーリングし、使用したリソースに対してのみ課金されるため、コスト効率の高いソリューションを実現します。
PII検出・秘匿化のメカニズムと実装の詳細
パイプラインの具体的な動作は、S3へのデータ投入から始まります。S3バケットにテキストファイルがアップロードされると、S3イベント通知が設定されたLambda関数をトリガーします。このLambda関数は、AWS Step Functionsのワークフロー実行を開始します。
Step Functionsは、以下のシーケンスでタスクを調整します。
-
PII検出: まず、Amazon Bedrock Data Automationを呼び出し、入力テキストからPIIタイプを検出します。開発者は、APIを通じてどのようなPIIタイプを識別するか、また検出されたPIIに対してどのようなアクション(例: マスク、置換)を適用するかを定義できます。例えば、
MASKアクションでは、検出されたPIIは[REDACTED]などのプレースホルダーに置き換えられます。 -
PII秘匿化: 検出されたPIIの場所とタイプに基づいて、再度Amazon Bedrock Data Automationを呼び出し、実際にテキスト内のPIIを秘匿化します。このステップでは、検出フェーズで特定された情報を利用し、指定された秘匿化ルールに従ってテキストを変換します。
-
結果の保存: 秘匿化されたテキストは、指定されたS3バケットに出力ファイルとして保存されます。同時に、処理結果やジョブのステータス情報がAmazon DynamoDBに記録され、管理者はパイプラインの実行状況を把握できます。
Amazon Bedrock Data Automationは、基盤となる大規模言語モデル(LLM)の能力を活用し、高い精度で多様なPIIパターンを識別します。これにより、複雑な文脈や非定形なデータ形式であっても、PIIを効果的に検出・秘匿化することが可能になります。この自動化されたアプローチは、手動での処理に比べて大幅な効率向上と一貫性のあるデータ保護を実現します。
開発者・エンジニア視点での考察
-
カスタムPIIタイプと秘匿化戦略の拡張性: Amazon Bedrock Data Automationは、一般的なPIIタイプをサポートするだけでなく、特定のビジネス要件に応じたカスタムPIIタイプ定義や、より高度な秘匿化ロジック(例: 特定のパターンを基にした部分的な置換、ハッシュ化)を組み込むための拡張ポイントを提供しているか、またはそのための設計パターンを検討すべきです。これにより、業界固有の機密データにも対応可能となります。
-
分散型パイプラインにおける監視とエラーハンドリング: このサーバーレスパイプラインは複数のAWSサービスにまたがるため、全体の健全性を把握するための集中型監視(Amazon CloudWatch Logs、Metrics、Alarms)と、各ステップでの堅牢なエラーハンドリング(Step Functionsのリトライ、Catch、Fallbackステート)の実装が不可欠です。特に、Bedrock Data Automationからの応答エラーやタイムアウトに対するリカバリ戦略を詳細に設計する必要があります。
-
データレイクとの統合とガバナンス強化: 秘匿化されたデータをS3に保存するだけでなく、AWS Lake Formationなどのデータレイクソリューションと統合することで、秘匿化されたデータのアクセス制御、カタログ化、監査をさらに強化できます。これにより、データアナリストや機械学習エンジニアは、プライバシーが保護された状態でデータに安全にアクセスし、分析やモデルトレーニングに活用できるようになります。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。