ToyBlocks:ロボット学習を切り分けて検証する制御可能なシミュレーション環境
FoundationWorldsの最初の実装として、ToyBlocksが狙うもの
AI2が発表したToyBlocksは、ロボット学習のデータ、モデル設計、失敗要因を、再現可能な条件下で調べるためのオープンなシミュレーション環境である。基盤となる考え方は、対象領域を絞った制御可能な世界と、タスク・訓練デモ・評価指標を生成するツールを組み合わせる「FoundationWorlds」だ。オープンな実環境を全面的に再現するのではなく、限定した領域で条件を変更し、同じ実験を繰り返せるようにする。
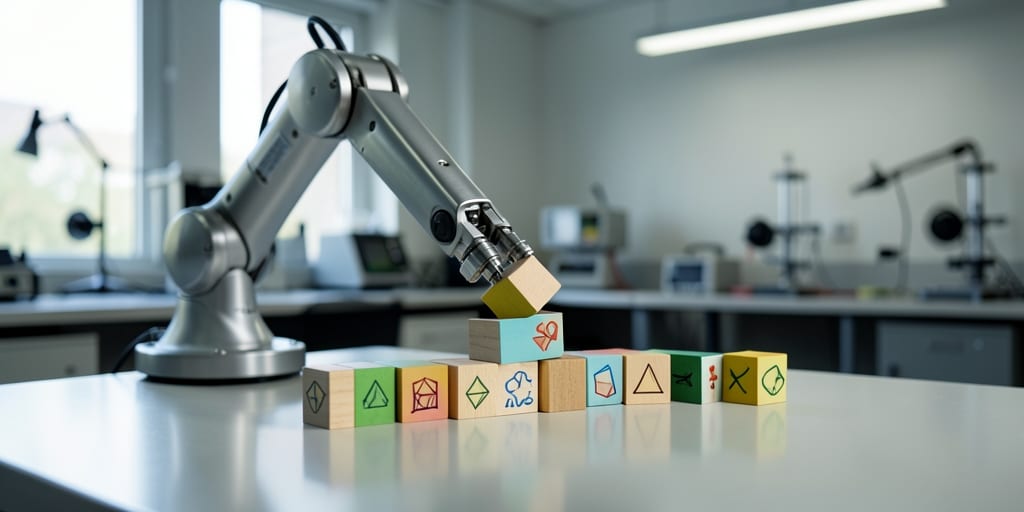
ToyBlocksの対象は、卓上のブロックとロボットアームである。ピッキングや積み上げに加え、押す、裏返す、回転させる操作を扱う。ブロック面には文字や画像があり、探索、分類、配置といった視覚的・意味的なタスクも作れる。目的の文字が隠れていれば、ブロックを回して面を確認してから、配置計画を立てなければならない。さらに、ブロック寸法やテーブル高などをシーンごとに変えるドメインランダム化により、形状変化への汎化も評価できる。
設計要件は、現実的な物理・外観、自動的なタスクとデモの大規模生成、推論と器用さを組み合わせた課題、領域内タスクの広いカバレッジの4点である。領域を狭く保つことで、ブロック間の相互作用や操作を集中的に扱いつつ、シミュレーション上のアームやブロックが実物に近い挙動をすることを目指す。モデルの成功率だけでなく、どのデータや操作経験が性能変化をもたらしたか、どの層で失敗が生じたかを調べやすくする点が重要だ。
デモ生成と階層制御を支える技術構成
ToyBlocksは、短い行動列で完了するスキルの学習と、それらをつなぐタスク実行を分けて構成する。スキル生成では、Isaac Lab上で強化学習(RL)を用い、押し操作や、ブロックをつかまずに別の面へ裏返す非把持操作などを学習する。モーションプランニングはアームの移動経路を計算する。シミュレータが直接提供できるブロックの正確な位置・姿勢などの特権情報をスキル生成に使うことで、実機では遠隔操作によるデータ収集が必要になり得る行動も自動生成できる。
デモ生成にはタスク・アンド・モーション・プランナー(TAMP)を用いる。TAMPがタスクに必要なスキルを選択・順序付けし、スキル間のロボット動作も計画する。計画をシミュレーション内で実行すると、デモ映像に加え、実行中のタスクやスキルを示すラベルが得られる。記事によれば、計画の生成と実行を単一GPU上で数百件並列化でき、最大で実時間の24倍の速度に達する。この処理量は、テレオペレーションの時間的制約を避けながら、スキル比率を調整した訓練データを作れる点で有用だ。
センサー入力から行動を出すモデルでは、シミュレータが直接知る姿勢をカメラ画像から推定する必要がある。高レベルの推論モデルが次に行うスキルを選び、低レベルの行動モデルがアームを制御する階層構造は、この認識・計画・実行を分離して検証する。評価時には成功率に加え、実行速度、物体に加わる力、プランナーと同じタスク仕様に基づく進捗も記録できる。したがって、タスク未達を単一の失敗ラベルにまとめず、認識、スキル選択、運動実行のどこに問題があるかを追跡しやすい。
汎化・長期計画・世界モデルを同一環境で検証
低レベル行動モデルの評価では、Stack、Unstack、Flip、Rotateの4タスクを使い、訓練範囲内の未見配置への補間と、訓練範囲外への外挿を区別する。検証条件には、物体配置領域、積み上げ段数、必要なスキル列、ブロック面の文字や色、シーン内のブロック数が含まれる。例えば、左側の領域だけで訓練して右側で試す、あるいは2段・5段の積み上げで訓練して3段・4段を評価する。記事は、ManiFlow、π0.5、MolmoAct 2を用いた初期結果で、大規模事前学習を経た行動モデルにも汎化の弱さが見られたと述べる。ToyBlocksでは、訓練データの分布境界やスキル構成を明示し、改善策の寄与を分析できる。
長期タスクでは、高レベル計画と低レベル実行の失敗を切り分けるため、両層に正解を与えるオラクルを用意できる。三文字をブロックで綴る課題では、開始時に文字が見えている条件、文字が正立していない条件、文字が初期状態で見えない条件へと難度を上げる。文字を見つけるための探索と、その後の積み上げ計画の両方が必要になる。高レベルモデルにMolmo 2、低レベルモデルにManiFlowまたはモーションプランナーを用いる構成は、選択したスキルと対象ブロックが適切だったか、指示された操作を低レベル側が実行できたかを分離して観察する例である。
ツールを介して行動するエージェントの検証では、Model Context Protocol(MCP)経由でピクセル位置を指定してスキルを呼び出し、画像観察に基づいて探索、配置、完了判定を行う。記事に記載された探索・綴り課題では、最大8個のブロックから三文字の語を構成する。シーンの半数には必要な文字がすべて存在せず、不可能と正しく判断することも要求される。エージェントは課題を解決するか不可能と正しく宣言するかを63%で達成し、主な誤りは似た文字の取り違え(13%)と、積み上げ時の文字向きの誤り(15%)だった。スキルの挙動を自ら試験し、説明を更新する実験では、成功率が既定説明の24%から63%へ上昇し、人間の専門家が作成した説明の36%も上回った。これは、ツール使用エージェントの性能が基盤能力だけでなく、操作仕様の発見・表現にも左右されることを示す。
世界モデルの評価にも、シミュレータの真の状態を参照できる利点がある。ピック・アンド・プレース、フリップ、回転、混合タスクについて各900軌跡を生成し、各スキルで成功例と空間配置の小さな変化による失敗例を半数ずつ含めた。評価では、初期画像と行動列から将来の画像・状態・潜在状態を予測させ、単一の相互作用区間と全軌跡の双方で、物体やグリッパーの位置、最終的な成功判定を比較する。記事ではWan 2.2がブロック運動とタスク結果を最も正確に予測し、Astraはグリッパー追跡に優れる一方で接触の再現に苦戦し、LeWMは短い区間では高速かつ高精度だが、全軌跡では誤差が蓄積すると報告されている。また、最良の動画生成モデルによるロールアウトを100件追加した実験では、未見領域における方策の成功率が19%から78%に上昇した。状態の真値を得られるシミュレータは、予測精度と、その予測を学習データとして使った場合の有効性を結び付けて評価する基盤となる。
開発者・エンジニア視点での考察
-
訓練分布を「データ量」だけでなく「経験の構成」として管理する。 ToyBlocksでは、押す・回す・裏返すデモの比率や、ワークスペース内外のサンプル配分を制御できる。開発では総データ数を固定した比較に加え、特定スキルの追加が別スキルの性能へ波及するかを、未学習タスクで評価するとよい。単純な成功率比較にとどめず、補間と外挿、対象スキル列、物体数などの条件を分けることで、データ増加の効果とカバレッジ改善の効果を区別できる。
-
観測・計画・制御を別々に計測する評価設計が有効である。 高低レベルのオラクル、タスク進捗、実行速度、接触力を組み合わせれば、「文字を見誤った」「正しい対象を選べなかった」「選んだ操作を実行できなかった」といった異なる失敗を区別しやすい。実運用へ移す際も、最終成功率だけでモデルを比較するのではなく、各層の介入によって改善可能な失敗を特定し、再学習対象を絞るべきである。
-
シミュレータと世界モデルの評価では、短区間と長軌跡を併用する。 単一の接触区間は物理相互作用の局所的な誤差を見つけやすく、全軌跡は誤差の累積や行動列全体への影響を明らかにする。さらに、予測指標だけでなく、生成ロールアウトを訓練に加えた後の方策性能まで測ることで、予測が「見た目にもっともらしい」だけなのか、実際に有用な追加データを生むのかを検証できる。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。