SageMaker AIで実現するエージェント蒸留:軌跡データから小型モデルへ
エージェントの「1タスク複数推論」を蒸留で置き換える
Amazon SageMaker AIを使い、フロンティアモデルのツール利用エージェントを、小型モデルへシーケンスレベル知識蒸留(SeqKD)する実装例が紹介された。対象は、価格や店舗評価などの条件を満たす商品を探すショッピングエージェントだ。エージェントは検索、候補の確認、条件の検証、推薦という複数段階を実行するため、1タスクが単一のモデル呼び出しでは終わらない。呼び出しごとに推論コストが発生し、利用量に比例して運用費が膨らむ。
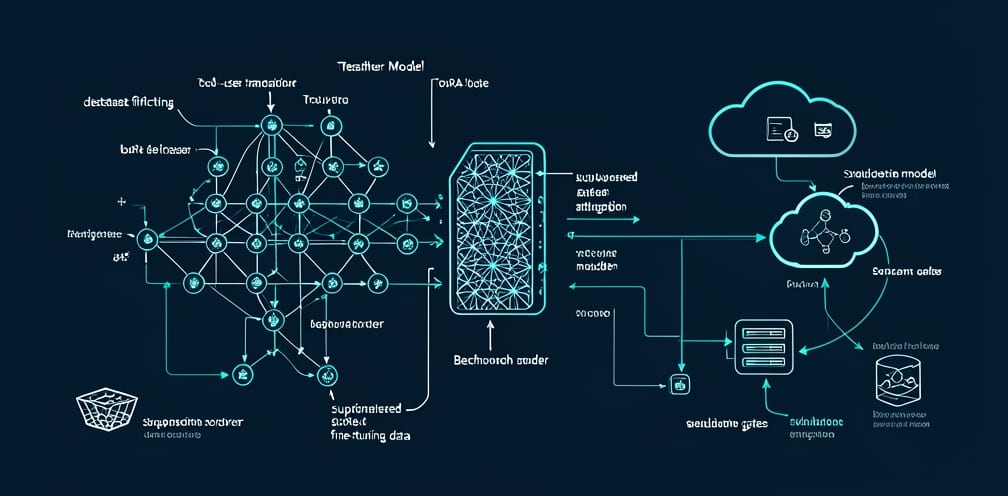
SeqKDでは、教師モデルが生成した出力を教師ありファインチューニング(SFT)の教師データにする。教師の重み、ロジット、勾配へのアクセスを必要とせず、API経由で利用するモデルのテキスト出力だけで実施できる。教師の出力はデータセットとして保存されるため、異なる学生モデルの学習や評価にも再利用できる。出力系列の全分布を再現するのではなく、教師が実際に生成したサンプルを模倣することで、実用的なコストと可搬性を得る設計だ。
エージェント向けの学習対象は最終回答だけではない。入力、推論、ツール呼び出し、環境からの観測が連なる一連の軌跡を使うことで、学生は次に出すべき行動と、そこへ至る複数ステップの振る舞いを学習する。記事の例では、Amazon Bedrock上の教師モデルがShoppingBenchのタスクを解き、SageMaker AIのモデルカスタマイズでQwen3.5-4BをSFTする。
成功軌跡の選別と、ステップ単位の学習データ化
学習データの品質を支えるのは、教師モデルの生成能力だけでなく、タスク固有の採点器による選別だ。ShoppingBenchは商品・店舗・クーポンの各意図について250問ずつ、計750問の合成ショッピング問題を公開している。記事では固定インデックスにより426問を学習用、324問を評価用に分割し、評価用の内訳は商品103問、店舗105問、クーポン116問とした。
学習用問題ごとに、推論を有効化し、温度1.0に設定したGLM-5.3を2回実行する。これにより得られる850軌跡をShoppingBenchのスコアラーで採点し、成功した軌跡だけを残す。温度1.0で複数回サンプリングする狙いは、異なる検索語や推論経路を探索し、少なくとも1つ成功する問題を増やすことにある。失敗例をそのまま模倣させず、成功した実行だけを学習に使う、棄却サンプリング型のデータ作成である。
軌跡は会話テンプレートに沿ったmessages形式へ変換し、各ステップを1つの学習行にする。user側にはシステムプロンプトと、それまでの会話・環境観測を含め、assistant側にはその時点の推論と次のツール呼び出しを置く。損失はassistant側だけに適用し、環境が返した観測をモデルに予測させない。成功軌跡から約2,600件の学習行と約130件の検証行が作られる。
長い会話履歴を各行に含めるため、データ設計にはトークン長の管理が欠かせない。記事の設定ではdataset_max_lenを16,384トークンとし、検索結果の生テキストを削って、次の判断に必要なID、価格、評価、制約確認用フィールドを残す。また、検索結果数や軌跡当たりのステップ数を制限する。データ分割は行単位ではなく問題単位で行い、同じ問題に由来する類似コンテキストが学習・検証間で漏れるのを防ぐ。
サーバーレスSFT、段階的評価、LoRAによる提供
学習にはSageMaker AIのサーバーレスSFTを利用する。SageMaker Python SDK v3のSFTTrainerで、JumpStartのhuggingface-vlm-qwen3-5-4bをベースモデルとして選び、学習・検証データセットとモデルパッケージグループを指定する。記事の構成はLoRAを使い、主要な設定は3エポック、グローバルバッチサイズ64、学習率0.0001、LoRAランク64、アルファ256(アルファ/ランク比4)、ウォームアップ比率0.1である。学習ジョブは管理サービスが実行し、メトリクスはAmazon SageMaker with MLflowで追跡する。専用の学習スクリプト、コンテナ、インスタンスを自前で管理しない点が特徴だ。
評価は、コストの低い事前チェックから始める。SageMaker AIモデル評価のCustom Scorerで、学生が出したツール名と教師の正解アクションを比較し、ツール選択と順序の一致を測る。引数の書式一致ではなく、どのツールをどの順で呼んだかを評価することで、構文差を排し、蒸留で移転させたい行動を直接確認する。ベースモデルも同じ条件で採点し、学生がベースを上回った場合に限って、商品検索サーバー、推論エンドポイント、複数ステップの実行を伴う高コストなエンドツーエンド評価へ進む。
提供時には、学生モデルがツールを実行するのではなく、推論結果としてツール呼び出しをテキスト出力する点に注意が必要だ。アプリケーション側の決定的なハーネスが出力を解析してツールを実行し、観測をモデルに返し、最終回答までループを回す。学生はLoRAアダプターとして配備し、ベースモデルの重みを複製せず、同一のリアルタイムエンドポイント上でベースとアダプターを別々の推論コンポーネントとして提供する。DJL LMIコンテナはバージョン0.36.0に固定し、vLLMエンジンを利用する。これにより、同じエンドポイントでベースと蒸留後の学生を比較できる構成となる。
開発者・エンジニア視点での考察
-
教師モデルの強さより、成功判定の信頼性がデータ品質を左右する。 生成した軌跡をそのまま使うのではなく、タスクの制約を評価できるプログラム型スコアラーで選別する設計が重要だ。独自業務に適用する際は、最終回答だけでなく、制約違反や許可されないツール操作も判定できる採点基準を整える必要がある。
-
学習データの分割単位と入力長は、モデル設定と同じくらい重要である。 同一問題由来の軌跡を行単位で分割すると、検証データに近似例が混入し、評価を過大に見積もるおそれがある。問題単位で分割したうえで、観測の圧縮とステップ数の上限を設け、トークン切り詰めによって判断材料が失われないか確認したい。
-
段階的評価と同一エンドポイント比較を、運用判断に結び付けられる。 ツール選択の低コスト評価でベースモデルを上回ることを、全件評価へ進むゲートにする。さらにベースモデルとLoRA学生を同一エンドポイントで切り替えられる構成なら、比較時の配備差を抑えやすい。ただし、事前チェックはツール選択を測る指標であり、タスク完了品質そのものを代替するものではないため、最終的な採否にはエンドツーエンド評価が必要だ。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。