NVIDIA Nemotron-Halloween:エッジAIが実現する超低遅延対話型エージェント
「Nemotron-Halloween」:対話型AIエージェントによるインタラクティブ体験
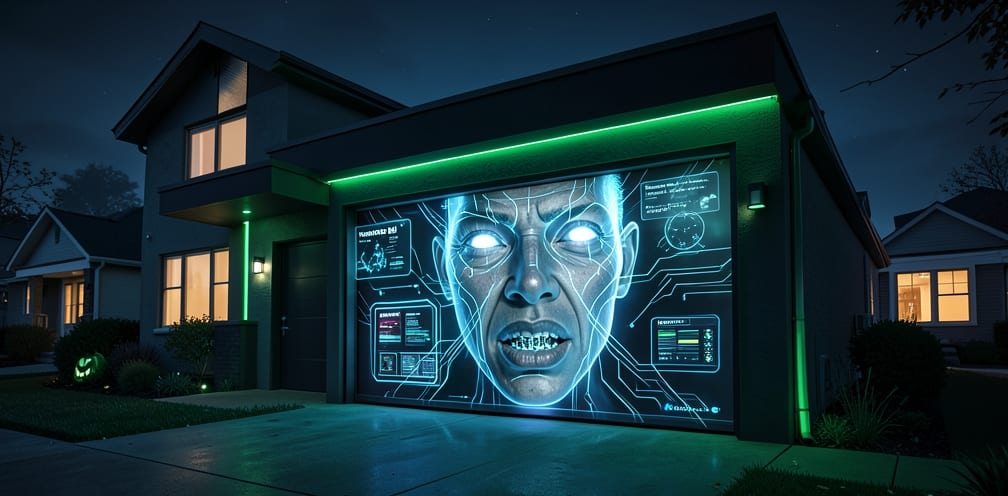
「Nemotron-Halloween」プロジェクトは、NVIDIAのオープンモデルであるNemotronファミリーを活用し、音声対話を通じてインタラクティブな体験を提供するハロウィン仕様のガレージドア、すなわち「話すハロウィンハウス」を実現しました。このデモンストレーションは、AIエージェントがリアルタイム対話において直面する主要な課題の一つである遅延の最小化に焦点を当てています。システムは、主に以下の技術スタックで構成されています。
- Brain (会話エンジン): Nemotron 3.5 Bolt E4B 4GBが中核を担っています。これは会話エージェント向けに設計されたオープンな小型言語モデルで、LoRA (Low-Rank Adaptation) を用いたパーソナリティアダプターが追加されています。
- Ears (音声認識): Nemotron Speech ASR(Streaming English 0.6Bモデル)が音声をテキストに変換します。
- Voice (テキスト読み上げ): Magpie TTS Zeroshotが、3〜10秒のリファレンスサンプルから感情を条件付けして音声を生成します。
- Face (顔のアニメーション): Unreal Engine 5内でカスタムリグを駆動するAudio2Face-3Dが、ガレージドアに表情豊かなアニメーションをもたらします。
このプロジェクトにおける重要な技術的工夫は、パイプラインが応答全体が生成される前に話せるテキストをリリースする点です。これにより、モデルの生来の速度だけでなく、知覚される遅延が大幅に削減され、家が文の残りの部分が生成されている間にも話し始めることができます。また、準備された挨拶やジョークはテキストバンクとして保存され、オーディオ記録がキャッシュされるため、新たな対話生成や音声合成をスキップすることで、キャッシュされた応答は0.72秒という驚異的な速度で返されます。
基盤技術:Nemotron 3.5 Bolt E4BとそのエッジAIにおける可能性
「Nemotron-Halloween」の会話エンジンの中心にあるNemotron 3.5 Bolt E4Bは、NVIDIAがエッジデバイスやローカル環境での高速かつ効率的なAIアシスタントワークロード向けに特別に設計した小型言語モデルです。
- アーキテクチャとパラメータ: GoogleのGemma 4 E4Bアーキテクチャをベースに後処理されており、総パラメータ数は80億ですが、任意の時点でアクティブなパラメータは40億に抑えられています(「E4B」の名称の由来)。
- 最適化された用途: 高速なファーストトークン応答、複数ターンにわたるツール使用、指示の追従、低メモリオーバーヘッドに焦点を当てており、音声インターフェースやオンデバイスエージェントなどのローカルアシスタントのユースケースに最適化されています。
- メモリ効率: 64Kトークンのコンテキストウィンドウをサポートし、Q4KM量子化フォーマットでは約4〜6GBのVRAMで動作するため、ラップトップ、エッジデバイス、および適度なローカルセットアップでの利用が可能です。
- ベンチマークと実世界性能: NVIDIA独自のベンチマークチャートでは、「スマートで高速」な領域に位置付けられ、同サイズの他の小型モデルを凌駕しつつ、最も小型のモデルと同等の応答速度を達成しています。実世界でのテストでは、デバッグタスクには失敗したものの、物理学の問題や論理的ななぞなぞなど、構造化された推論タスクでは堅実な正解を返しており、特定のタスクにおける強みを示しています。
このモデルは、限られたリソース下で高性能な対話型AIを構築するためのNVIDIAのアプローチを体現しており、その効率性とローカルでの実行可能性がエッジAIアプリケーション開発に大きな可能性を拓きます。
Nemotronエコシステムが推進する次世代エージェントAI
NVIDIA Nemotronファミリーは、Bolt E4Bのようなエッジ向けモデルだけでなく、より複雑なエージェントワークフローをサポートするための高度なモデルも提供しています。例えば、Nemotron 3.5 Super VLは、1200億の総パラメータと120億のアクティブパラメータを持つ混合専門家(MoE)アーキテクチャのマルチモーダルモデルであり、推論、指示追従、ツール使用、テキスト、画像、文書、ビデオの理解を単一モデルで実現します。 このモデルは、単一のGPUで同サイズの他のオープンモデルと比較して最大5倍のスループットを実現し、エージェントタスクにおける効率を大幅に向上させます。
Nemotron 3.5 SuperやNemotron 3.5 Lightningといったモデルは、Mamba-2ステートスペースレイヤー、スパースアテンションレイヤー、MoEルーティングを組み合わせたハイブリッドアーキテクチャを採用しています。 この設計は、エージェントループにおけるキーバリュー(KV)キャッシュの膨張というTransformerモデルのボトルネックに対処し、長大なコンテキストでのエージェントワークロードにおいて効率的な推論を実現します。Mambaレイヤーは履歴を固定サイズの再帰状態に圧縮するため、シーケンス長に関わらずメモリ消費を一定に保ちます。 これらの進歩は、AIエージェントがより複雑なエンタープライズワークフローに対応し、ドキュメントの読み取り、複数の情報源のチェック、ポリシーの遵守、複数のツールの呼び出しといったタスクを効率的に実行できるようにします。
開発者・エンジニア視点での考察
-
エンドツーエンドの遅延最適化の重要性: Nemotron-Halloweenプロジェクトは、生のモデル速度だけでなく、応答の生成中にテキストを早期にリリースしたり、頻繁に使用される応答をキャッシュしたりすることで、知覚される遅延を大幅に削減する戦略の重要性を強調しています。インタラクティブなAIアプリケーションを開発する際には、モデルの推論速度だけでなく、パイプライン全体での遅延削減技術の導入がユーザーエクスペリエンスに不可欠であると再認識させられます。
-
特化型小型モデルとアダプターの戦略的活用: Nemotron 3.5 Bolt E4Bのような、限られたリソース(4-6GB VRAM)で高速な応答を可能にする小型モデルを、LoRAアダプターで特定のパーソナリティやタスクに合わせてカスタマイズするアプローチは、エッジデバイス上でのAI展開において非常に有効です。これにより、大規模なモデルを必要とせずに、特定のユースケースに特化した高性能なAIエージェントを効率的に構築できる可能性が広がります。
-
会話型AI評価における人間中心のアプローチ: 記事がベンチマークと品質評価において「耳で判断する (judge by ear)」というループ(会話生成、アダプター訓練、反復とタイミング測定、そして聞き取りによる評価)を強調している点は重要です。これは、数値的な指標だけでは捉えきれない会話の自然さ、適切さ、ユーザーの満足度といった質的な側面を評価するために、人間の介入が不可欠であることを示唆しています。開発者は、自動評価指標と並行して、ユーザーテストや専門家による主観的評価を組み込むことで、より質の高い会話型AIを開発できるでしょう。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。