Amazon SageMaker AIにおけるKokoro TTSを活用したAIエージェントからの低遅延音声ストリーミング
Kokoro TTSの技術概要とAmazon SageMakerへのデプロイ
AIエージェントにおけるユーザーエクスペリエンスを向上させる上で、音声合成(TTS: Text-to-Speech)の低遅延化は極めて重要です。本レポートでは、軽量かつ高品質なTTSモデルであるKokoro-82MをAmazon SageMaker AI上で展開し、低遅延ストリーミングを実現する技術とアーキテクチャについて詳述します。
Kokoro-82Mは、わずか82Mのパラメータ数と2GB未満のVRAM要件という超軽量設計でありながら、非常に自然な英語の音声を生成できることが特徴です。リアルタイムまたはそれ以上の速度での推論が可能であり、Apache 2.0ライセンスの下で提供され、アメリカ英語およびイギリス英語の複数の音声スタイルをサポートします。さらに、ストリーミング生成に対応しており、日本語や中国語を含む多言語サポートも提供されます。これらの特性から、チャットボットやエッジデプロイメントなどのリアルタイムアプリケーションに理想的です。
Amazon SageMaker AIへのデプロイでは、Kokoro-82Mは非同期推論エンドポイントとして構成されます。このアーキテクチャでは、テキスト入力はJSONペイロードとしてエンドポイントに送信され、音声合成後にWAVファイルとしてAmazon S3バケットに書き込まれます。モデルの重みと音声データは、コンテナイメージのビルド時に直接組み込まれるため、ランタイムでのモデルダウンロードが不要となり、起動時間の短縮に貢献します。デプロイプロセス全体はAWS CloudFormationスタックによって自動化され、S3バケット、IAMロール、SageMakerモデル/エンドポイント設定/エンドポイントなどのリソースがプロビジョニングされます。
低遅延ストリーミングとスケーラビリティの最適化
AIエージェントとの対話において、ユーザーは即座の応答を期待するため、音声合成における低遅延は必須要件です。Kokoro-82Mはストリーミング生成をサポートしており、長文のテキストに対してもチャンク単位での合成と出力が可能であるため、ユーザーは音声の途切れなく聞き始めることができます。
スケーラビリティの最適化は、コスト効率と応答速度のバランスを取る上で重要な課題です。本ソリューションでは、Amazon SageMakerのオートスケーリング機能が活用されており、特に「スケール・トゥ・ゼロ」機能により、アイドル状態のインスタンスにかかるコストを削減します。オートスケーリングのポリシーは、HasBacklogWithoutCapacityに基づくステップポリシーとApproximateBacklogSizePerInstanceに基づくターゲット追跡によって構成され、バックログの存在とインスタンスあたりのリクエスト数に基づいて動的に容量を調整します。
AWSが提供するサンプルでは、オートスケーリング設定のために静的な目標値を用いるのではなく、ライブ測定に基づいたアプローチを推奨しています。これは、tts-benchツールを用いて、リアルタイムのエンドポイントの動作を測定し、その結果から最適なオートスケーリング設定を導き出すものです。これにより、過剰なプロビジョニングによるコスト増大や、過少なプロビジョニングによる遅延リスクを回避し、サービスレベルアグリーメント(SLA)を満たすための最適なキャパシティ計画が可能になります。
アーキテクチャ詳細と実践的なベンチマーク
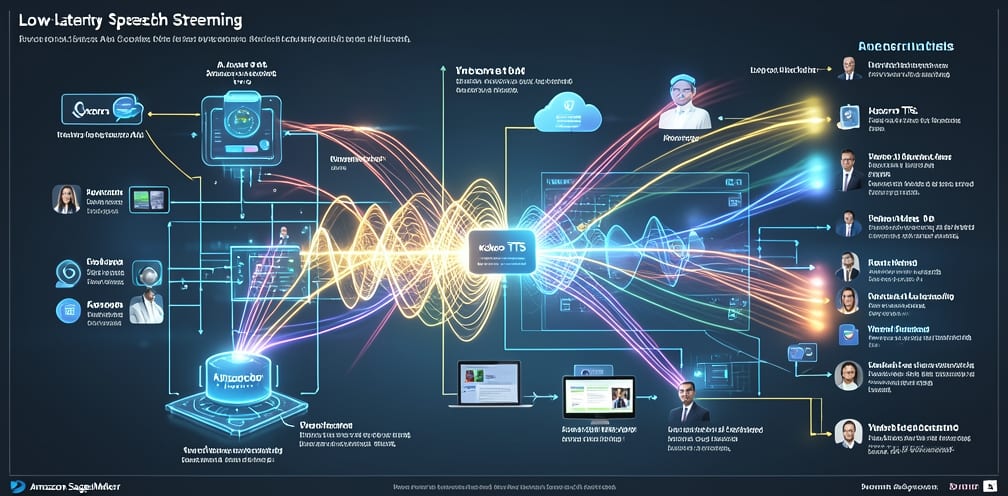
本ソリューションのアーキテクチャは、Amazon SageMakerを中核としたコンテナベースのデプロイメントモデルを採用しています。推論コンテナはPyTorch inference DLCを拡張し、Kokoroモデルと音声データを組み込んでAmazon ECRに格納されます。クライアントからのリクエストはSageMakerエンドポイントを通じて処理され、S3が非同期I/Oのストレージ層として機能します。AWS CloudFormationテンプレート(template.yaml)は、S3バケット、IAM実行ロール、SageMakerモデル/エンドポイント、そしてAWS Application Auto Scalingポリシーなど、必要なすべてのAWSリソースを一貫してプロビジョニングします。
性能ベンチマークに関しては、tts-benchツールが遅延、スケーラビリティ、コストを測定するために用いられます。このツールは、ライブエンドポイントの計測された振る舞いをオートスケーリング設定に変換する機能を提供します。例えば、Kokoro-82Mのテストにおいて、インスタンスあたり50の同時リクエストで、95パーセンタイルにおいて3秒以内の初回オーディオ応答目標を達成できたことが報告されています。しかし、60リクエストでは目標値を逸脱しました。また、新たなキャパシティが有用になるまでの計画時間は、ポリシー検出の60秒を含めて320.2秒と測定されており、これにより具体的なスケーリング戦略を立案するための重要なデータが提供されます。
この測定主導型のアプローチにより、開発者はインスタンスが処理できる最大負荷と、追加キャパシティが利用可能になるまでの時間を正確に把握できます。これにより、アイドル状態のGPUに対する不必要な支払いと、キューの発生による応答速度の低下というトレードオフを最適に管理することが可能になります。
開発者・エンジニア視点での考察
-
実測に基づいたオートスケーリング戦略の適用: 開発者は、静的な設定に頼るのではなく、
tts-benchのようなツールを使用して実際の負荷状況下でモデルのパフォーマンス(特に遅延とスループット)を測定し、その結果に基づいてAmazon SageMakerのオートスケーリングポリシーを動的に調整すべきです。これにより、コスト効率とSLA要件のバランスを最適化し、変動するトラフィックパターンに対して強靭なシステムを構築できます。 -
ストリーミング合成とチャンク処理の設計パターン: リアルタイム対話型AIアプリケーションを開発する際、長文テキストを処理するためにKokoro TTSが採用する「チャンク化されたストリーミング合成」は重要な設計パターンとなります。開発者は、フロントエンドとバックエンドのインターフェース設計において、音声データを小規模なチャンクで送信・受信する仕組みを実装し、ユーザーの体感的な遅延を最小限に抑えることを検討すべきです。
-
モデルとインフラのコンテナイメージへの統合: Kokoro TTSのデプロイでモデルの重みと音声がDockerコンテナイメージに事前に組み込まれている点は、開発者にとって重要な教訓です。これにより、推論エンドポイントの起動時間が短縮され、特にスケール・トゥ・ゼロ戦略を採用している場合にコールドスタートの遅延を大幅に削減できます。カスタムAIモデルをSageMakerにデプロイする際も、同様のアプローチで推論リソースの効率を最大化する設計を考慮すべきです。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。