脳スキャンから視覚を再構築するAI「Brain-IT」:革新技術と倫理的考察
革新的な視覚再構築AI「Brain-IT」の概要
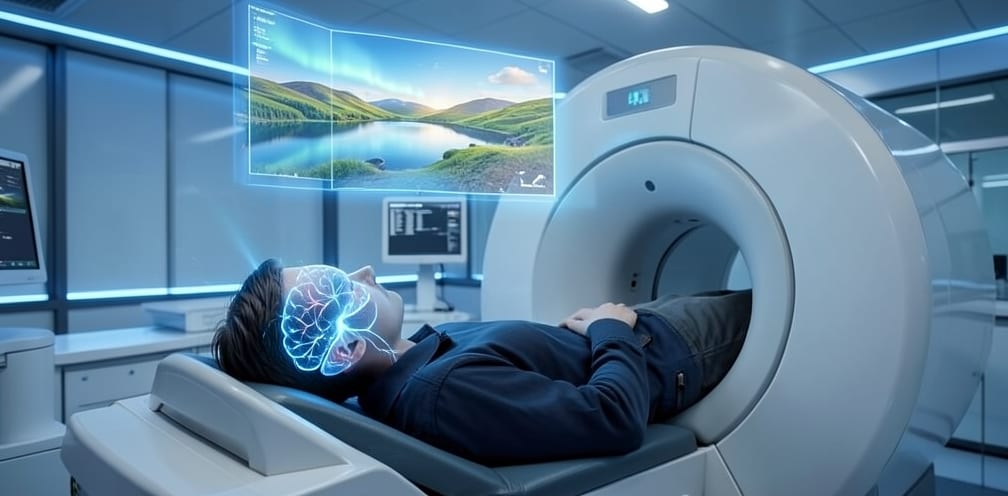
イスラエルのワイツマン科学研究所の研究チームは、fMRI(機能的磁気共鳴画像法)データのみから、人が見ている視覚情報を高精度で再構築するAIシステム「Brain-IT」を開発しました。本成果は2026年10月の認知計算神経科学会議や国際学習表現会議(ICLR 2026)で発表され、その革新性が注目されています。研究を主導したミハル・イラニ教授は、既存の脳スキャンからの画像再構築手法を大幅に上回る性能を達成したと述べています。
この技術の最も画期的な点は、新規被験者に対して、従来の約40時間を要したキャリブレーション(適応)に必要なスキャン時間をわずか1時間にまで短縮したことです。これにより、高額なスキャンコストの削減と研究効率の向上が期待され、脳の視覚処理メカニズムの解明が加速される可能性があります。
技術的アプローチとアーキテクチャ詳細
Brain-ITシステムの成功は、その独創的なアーキテクチャ設計にあります。従来の試みが脳信号を直接画像に翻訳しようとし、しばしば不明瞭な結果やAIによる誤った詳細生成に繋がっていたのに対し、Brain-ITはより洗練された多段階アプローチを採用しています。
具体的には、脳信号を直接翻訳するのではなく、2つの異なるニューラルネットワークで構成されるデコーダを使用します。これらはそれぞれ、画像の「構造(レイアウト)」と「内容」を別々に予測します。この分離された予測は、最終的に画像生成モデル(例えば拡散モデル)に入力され、より詳細で忠実な画像を生成します。これにより、オブジェクトの位置や色などの重要な詳細を正確に捉えることが可能になりました。
さらに、システムは逆方向エンコーダも活用しています。このエンコーダは、与えられた画像から脳活動がどのように反応するかを予測する役割を担います。これにより、実際にスキャンを伴わない約12万枚、全体の約70%に及ぶ膨大なシミュレーションデータを生成し、訓練データセットを大幅に拡張することができました。この合成データは、モデルの汎化能力と頑健性の向上に大きく貢献しています。
訓練には、8人の被験者が高解像度fMRIスキャナー内でそれぞれ約9,000枚の写真を閲覧した公開データセット「Natural Scenes Dataset」が用いられました。このデータセットは、個々の脳が視覚情報にどのように反応するかに関する広範な事例を提供しています。Brain-ITは、約1立方ミリメートルのスポットをカバーする高精細なfMRIスキャナーによって得られた、よりシャープな脳活動データを利用しています。
応用可能性と深刻な倫理的課題
Brain-ITのような脳再構築AIの進展は、科学と医療に多大な応用可能性を秘めています。基礎研究の観点からは、脳の視覚処理メカニズムのより深い理解に貢献し、認知科学に新たな洞察をもたらすことが期待されます。臨床応用としては、筋萎縮性側索硬化症(ALS)や脳卒中などによりコミュニケーション能力を失った閉じ込め症候群の患者が、視覚イメージを通じて意思伝達を行う手段を提供する可能性があります。また、夢や想像しているイメージ、さらには内省状態の視覚化といった、これまでアクセス困難だった脳内の情報の再現も将来的な展望として挙げられています。この研究は、記憶、創造性、精神衛生の理解に新たな窓を開く可能性を秘めています。
しかしながら、この技術は深刻な倫理的課題も提起しています。特に懸念されるのは、個人のメンタルプライバシーの侵害リスクです。将来的には、より手軽なウェアラブルEEG(脳波計)機器と組み合わせることで、日常環境下での非侵襲的な思考解析が可能になる可能性が指摘されています。これにより、本人の同意なしに頭の中のイメージやプライベートな思考が抽出されるリスクが高まります。神経倫理学者は、技術の商業的悪用や、個人の脳データが法廷証拠として使用される可能性に対し懸念を表明しており、技術の倫理的ガバナンスの整備が急務であると警鐘を鳴らしています。研究チームは、現時点では治療・基礎研究目的への限定を明言していますが、技術の進展に伴い、プライバシー保護の枠組みの構築が今後の鍵となるでしょう。
開発者・エンジニア視点での考察
-
モダリティ変換における中間表現と教師信号拡張の戦略性: 脳活動(fMRI)という非視覚モダリティから視覚画像を再構築する際、直接的なエンドツーエンド変換ではなく、画像の「構造」と「内容」を分離した中間表現を導入している点は注目に値します。さらに、画像から脳活動を予測するエンコーダを活用し、実際にスキャンされていない画像からも合成の訓練データを生成するアプローチは、データ収集が困難なドメインにおける限られた教師データから複雑なモダリティ変換を実現するための、汎用的かつ効率的な教師信号拡張戦略として応用可能です。これは、医療画像処理、科学シミュレーション、ロボットの感覚データ処理など、多様な分野でのAIシステム開発において重要なヒントとなります。
-
効率的な転移学習とパーソナライズAIの実現: 新規被験者への適応時間(キャリブレーション)を40時間から1時間へと大幅に短縮できたことは、大規模な基盤モデルによる汎化能力と、少量の個別データによる効率的なファインチューニングのバランスが優れていることを示しています。これは、個々のユーザーに最適化されたAIシステム(パーソナライズAI)を開発する上で極めて重要です。多様なデータで事前学習されたモデルをベースに、特定のユーザーや環境のデータで迅速にドメイン適応を行うことで、高コストなデータ収集や訓練を回避しつつ、高精度なカスタマイズを可能にする設計思想は、開発者が多様なAIアプリケーションを展開する上で模範となり得るでしょう。
-
多段階生成アーキテクチャと制御可能性の向上: 脳活動から最終画像を生成するプロセスを「構造デコード」「内容デコード」「画像生成(拡散モデル)」という多段階に分割するアーキテクチャは、複雑な生成タスクにおいて、各段階の出力をより細かく制御できる可能性を示唆しています。開発者は、単一のブラックボックス的な生成モデルに頼るだけでなく、問題空間を論理的なサブタスクに分割し、それぞれのサブタスクに特化したモデル(例:GAN、VAE、各種Diffusion Model)を組み合わせることで、生成プロセスをより透明化し、特定の要素(例:オブジェクトの配置、色彩、スタイルなど)を意図的に操作可能な、高精度かつ制御性に優れた生成AIシステムを構築するための設計パターンとして活用できるでしょう。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。