Amazon Bedrock AgentCoreとStrands Evalsによるスキル装備エージェントの評価:実践的アプローチと品質保証
スキル装備エージェント評価の課題とAmazon Bedrock AgentCoreの役割
AIエージェントの進化は目覚ましいものがありますが、その非決定論的な出力や、複数のターンにわたる複雑な文脈依存的な意思決定は、従来のソフトウェアテスト手法では評価が困難であるという課題を抱えています。特に、外部ツールを使用する「スキル装備エージェント」においては、最終的な結果だけでなく、エージェントがどのようにツールを選択し、推論し、行動したかのプロセス全体を評価する必要があります。
Amazon Bedrock AgentCore Evaluationsは、この課題に対応するために設計されたフルマネージドサービスであり、AIエージェントの自動品質評価を提供します。このサービスは、本番環境のトラフィックを継続的に監視する「オンライン評価」と、開発およびCI/CDパイプラインでのプログラム的なテストを可能にする「オンデマンド評価」の2つの主要な評価タイプを提供します。応答の品質、安全性、タスク完了度、ツール使用の正確性など、AIエージェントの性能を測定するための13種類の組み込み評価器が用意されています。さらに、開発者は参照回答や行動アサーション、期待されるツール実行シーケンスなど、Ground Truthデータを用いてエージェントのパフォーマンスを期待値と比較測定することができます。これにより、AIエージェントの動作に関する深い洞察を得て、品質を体系的に保証することが可能になります。
Strands Evalsフレームワークによる体系的なテスト
Strands Evalsは、特にStrands Agents SDKで構築されたAIエージェント向けに設計された包括的な評価フレームワークです。このフレームワークは、AIエージェント特有の非決定性出力や複雑なインタラクションパターンに対応するため、従来のユニットテストの概念を拡張したアプローチを採用しています。
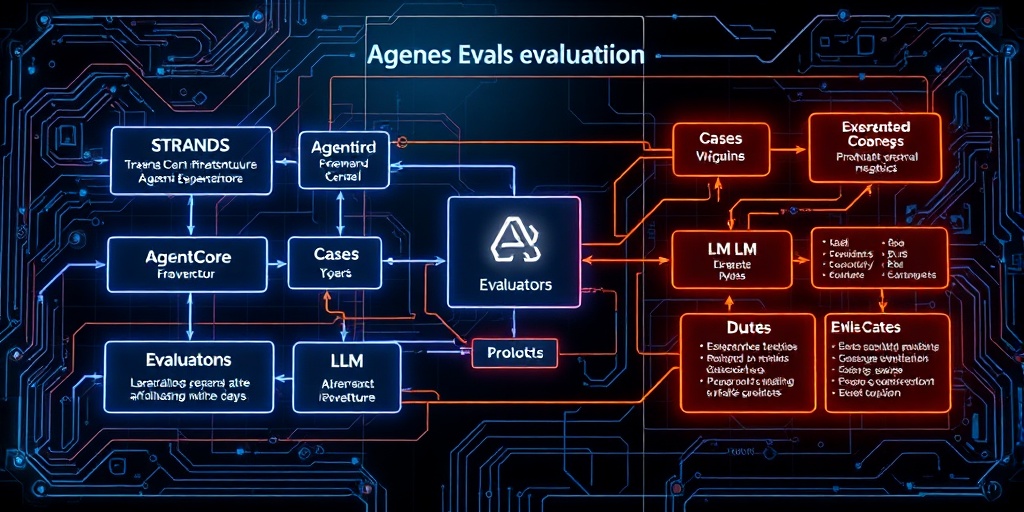
Strands Evalsの核となる概念は以下の3つです。
- Cases (ケース): 単一のテストシナリオを表します。ユーザーのクエリ、期待される出力、期待されるツール利用の軌跡(trajectory)、およびメタデータを含みます。
- Experiments (実験): 複数のCaseをまとめたもので、1つ以上の評価器と組み合わせて実行されるテストスイートに相当します。Experimentは、各Caseに対してエージェントを実行し、設定された評価器を適用して結果をスコアリングするプロセスを統括します。
- Evaluators (評価器): エージェントの出力(実際の出力と軌跡)を検証し、期待値と比較してスコアリングを行う役割を担います。Strands Evalsの評価器は、主にLLMを「ジャッジ(LLM-as-a-Judge)」として利用し、より高度で判断ベースの評価を行います。
Strands Evalsは、ヘルプフルネス、忠実性、有害性、ツール選択精度、ツールパラメータ精度、目標達成率などをカバーする多数の組み込み評価器を提供します。また、LLMを使用して高レベルな記述から多様なテストケースや評価ルーブリックを自動生成するExperimentGenerator機能も備わっており、テストスイートの作成を効率化します。マルチターン会話シミュレーション、出力評価、軌跡分析、ツール使用評価など、多様な評価タイプをサポートし、開発中のオンライン評価と本番環境のオフライン分析の両方に対応します。
AgentCoreとStrands Evalsの統合による継続的品質保証
Strands EvalsとAmazon Bedrock AgentCore Evaluationsは、OpenTelemetry計測を介してシームレスに統合されます。これは、AIエージェントの継続的な品質保証にとって極めて重要な側面です。エージェントの各インタラクションやツール呼び出しは、業界標準のオブザーバビリティフレームワークであるOpenTelemetryのトレースとしてキャプチャされ、Amazon CloudWatchに送信されます。
AgentCore Evaluationsは、これらのトレースを読み取り、大規模言語モデル(LLM)をジャッジとして活用することで、エージェントの応答の有用性、正確性、ツール選択の精度といった多次元的な品質を評価します。この統合により、開発者はCI/CDパイプラインに「品質ゲート」を容易に組み込むことができます。具体的には、オンデマンド評価を実行し、評価スコアが定義された閾値を下回った場合に、コード変更のプルリクエスト(PR)をブロックするといった自動化された回帰テストフローを構築できます。これにより、本番環境にデプロイされる前にエージェントの性能劣化を確実に検出し、品質を維持することが可能になります。
さらに、Strands Evalsの評価結果はCloudWatch LogsにEmbedded Metric Format (EMF) で送信され、Amazon Bedrock AgentCoreのGenAI Observabilityダッシュボードで視覚化できます。これにより、評価スコア、成功/失敗率、詳細な説明をリアルタイムで監視し、エージェントのトレースやセッションと関連付けて分析することで、運用中のエージェントの品質を継続的に把握できます。このアーキテクチャは、LangGraph、OpenAI Agents SDK、LlamaIndexなど、他の主要なエージェントフレームワークで構築されたエージェントも、OpenTelemetryを通じてAgentCore Evaluationsで評価できるため、高い汎用性を提供します。
開発者・エンジニア視点での考察
-
出力だけでなく行動・軌跡に着目した評価の重要性: エージェントの自律的な性質を考慮し、最終的な出力だけでなく、内部的な推論プロセス、ツール選択、API呼び出し順序などの「行動(Behavior)」をOpenTelemetryトレースで捕捉し、評価するアプローチが、信頼性の高いAIエージェント開発に不可欠である。これにより、不適切なツール呼び出しやポリシー違反といった潜在的な問題を早期に特定し、根本原因を診断することが可能となる。
-
CI/CDへの評価組み込みによる開発サイクルの加速: Amazon Bedrock AgentCore Evaluationsのオンデマンド評価を活用し、GitHub ActionsなどのCI/CDパイプラインに自動評価を組み込むことで、コード変更によるエージェントの性能低下(リグレッション)を自動検出し、本番環境へのデプロイ前に品質を保証できる。これにより、開発者は品質に対する自信を持って、迅速かつ継続的にエージェントの改善イテレーションを進めることができる。
-
ドメイン特化型評価のための柔軟なカスタマイズ性: 汎用的な組み込み評価器に加えて、ビジネスロジックや特定のドメイン要件に合わせたカスタム評価器を、LLMベースまたはPython/JavaScriptによるコードベース(Lambda関数経由)で自由に定義できる機能は、極めて強力である。これにより、エージェントの品質評価を特定のユースケースにおける成功基準に合わせて細かく調整し、より実用的な測定と最適化を実現することが可能となる。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。