産業安全AIの高度化:Amazon SageMakerにおける合成データ活用戦略
産業安全AIにおけるデータ収集の課題と合成データの可能性
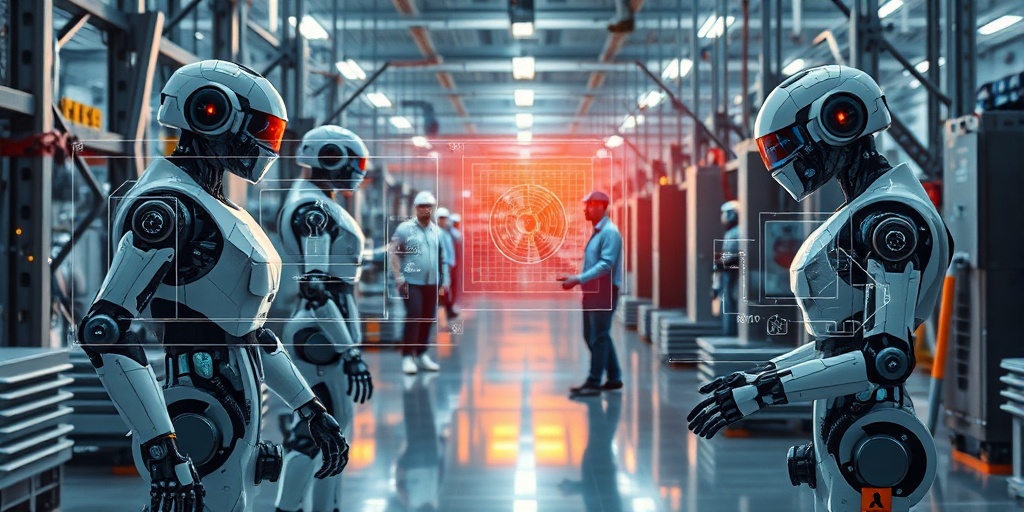
産業分野におけるAI導入は、作業員の安全確保において革新的な進歩をもたらしています。特にコンピュータビジョンを用いた危険検知やPPE(個人用保護具)装着状況の監視は、事故防止に不可欠です。しかし、これらのAIモデルを効果的に訓練するためのデータセットの確保には、複数の深刻な課題が存在します。最も重要なのは、重機に危険なほど接近している作業員や、死角にいる人、または移動中の機器の近くにいる子供など、高リスクかつ稀なシナリオを捉えた訓練画像が極めて不足している点です。このような「エッジケース」は、実際のデータセットでは自然に発生しにくく、意図的に収集しようとすると非倫理的かつ危険を伴います。結果として、データ不足やクラスの不均衡が生じ、AIモデルの堅牢性や信頼性が損なわれるリスクがありました。
この課題に対する強力な解決策として注目されているのが、合成データの活用です。合成データは、実際の環境から収集するのではなく、シミュレーションや生成モデルを用いて人工的に作成されたデータであり、データ不足、ラベリングコストの削減、モデルの堅牢性向上、プライバシー保護といった多岐にわたる利点をもたらします。特に、危険なシナリオを安全かつ倫理的に多数生成できるため、産業安全AIの訓練データとして非常に有効です。例えば、GLIGEN(Grounded Language-to-Image Generation)のような拡散ベースの生成モデルは、合成画像の品質向上に貢献し、誤検知のリスクを低減し、運用環境のより正確な状況理解を可能にします。初期の実験では、合成データのみで訓練された人検出モデルがmAP50(Intersection over Union閾値0.5における平均平均精度)で最大160%の改善を示し、手動アノテーションや危険な写真撮影なしに高い精度を達成できることが実証されています。
Amazon SageMakerを活用した合成データ駆動型AI開発ワークフロー
Amazon SageMakerは、機械学習モデルの構築、トレーニング、デプロイメントをエンドツーエンドでサポートするフルマネージドサービスであり、合成データを活用した産業安全AIのライフサイクル全体を効率化します。このプラットフォームは、画像、テキストファイル、動画などの未加工データへのラベリング機能に加え、合成データ生成のための基盤も提供します。
典型的なワークフローは以下のステップで構成されます。
-
シナリオ定義とデータ要件の特定: どのような安全課題を解決するかを明確にし、AIモデルが必要とするデータの種類と量を定義します。
-
合成データ生成: Blender、Unreal Engine、Unityなどの3Dレンダリングツールや、AI.Reverie、Synthetaic、CVEDIAのような専門的な合成データプラットフォームを活用し、多様な環境、作業員、PPE、危険シナリオのフォトリアリスティックな画像を生成します。生成プロセス中に自動的にラベル付けを行うことで、手動でのアノテーション作業を大幅に削減できます。統計的分布分析や、敵対的生成ネットワーク(GAN)、変分オートエンコーダー(VAE)のようなディープラーニング手法も、高品質な合成データセット作成に利用されます。
-
データセットの準備と管理: 生成された合成データは、Amazon S3などのストレージサービスに格納されます。必要に応じて、Amazon SageMaker Ground Truthを使用して、現実世界のデータに対する追加のラベリング作業を実施することも可能です。Amazon EventBridgeとAWS Step Functionsを連携させることで、SageMaker Ground Truthのラベリングジョブを定期的に自動生成するパイプラインを構築できます。
-
モデルトレーニング: Amazon SageMakerの強力なトレーニング機能を利用して、合成データセットでオブジェクト検出モデル(例: YOLOv8モデル)を訓練します。PyTorch 2.1とAdamW最適化を含む設定は、特に大規模なYOLOv8lモデルの安定化とトレーニング中の勾配発散防止に非常に重要であることが示されています。 SageMakerは分散トレーニング、ハイパーパラメータチューニング、MLOpsプラクティス(SageMaker Pipelinesによるワークフローのログ記録、SageMaker Model Monitorによるモデルパフォーマンス監視)もサポートし、開発プロセス全体の透明性と監査可能性を高めます。
-
モデル評価とデプロイ: 訓練されたモデルは、Amazon SageMaker Endpointを介してデプロイされ、リアルタイムまたはバッチ推論に使用されます。
技術的考察と開発者視点での実践的洞察
Amazon SageMakerと合成データの組み合わせは、産業安全AI開発におけるゲームチェンジャーとなります。特に、コンピュータビジョンモデルの精度と堅牢性を向上させる上で、現実世界では収集困難なエッジケースのデータを豊富に提供できる点が大きな強みです。
このアプローチの成功は、合成データの「リアリズム」と「多様性」に大きく依存します。生成される合成データは、実際のセンサーデータとのドメインギャップを最小限に抑えるよう、光源、質感、視点、ノイズなどを忠実に再現する必要があります。また、多様なシナリオ、天候条件、機器の種類、作業員の服装などを網羅することで、訓練されたモデルが未知の状況でもロバストに機能するようになります。SageMakerの実験管理機能やモデルレジストリを活用することで、異なる合成データセットやトレーニング設定によるモデル性能の変化を体系的に追跡し、最適なモデルを見つけることができます。
開発者・エンジニア視点での考察
-
ドメイン適応と転移学習の戦略的導入: 合成データのみで訓練されたモデルは、現実世界のデータに対してドメインシフトの問題を抱える可能性があります。これを軽減するため、少量の現実世界データを取得し、SageMaker上でファインチューニングやドメイン適応技術(例: ドメインアドバーサリアル学習、特徴量アラインメント)を適用することで、モデルの実用性を大幅に向上させることが可能です。これにより、合成データの利点を享受しつつ、現実世界でのパフォーマンスギャップを埋めることができます。
-
合成データ生成パイプラインのMLOps化: 合成データ生成プロセス自体をMLOpsパイプラインに組み込むことで、データの品質管理、バージョン管理、再生成の自動化を実現できます。Amazon SageMaker Pipelinesを活用し、合成データ生成ツール(例: Blenderスクリプト、GANモデル)をコンテナ化し、パラメータ変更に応じて自動的に新しいデータセットを生成・評価するワークフローを構築することで、反復的なAI開発サイクルを加速できます。
-
エッジデプロイメントと効率的な推論: 産業安全AIはしばしば、工場や建設現場などのエッジデバイスでリアルタイムに動作する必要があります。SageMaker NeoやSageMaker Edge Managerを利用して、訓練済みモデルをエッジデバイス向けに最適化し、効率的な推論を実現することが重要です。これにより、ネットワーク帯域幅の制約がある環境でも、低レイテンシで高精度な安全監視が可能となります。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。