NVIDIA FLAREによるフェデレーテッドラーニングのスケーラビリティ:Docker、Kubernetes、Slurmを横断した展開戦略
NVIDIA FLAREの分散型学習アーキテクチャとその利点
NVIDIA FLARE(Federated Learning Application Runtime Environment)は、ドメインに依存しないオープンソースのフェデレーテッドラーニング(FL)SDKであり、研究者やデータサイエンティストが既存の機械学習(ML)および深層学習(DL)ワークフローを分散パラダイムに適応させ、プラットフォーム開発者がセキュアでプライバシーを保護するマルチパーティコラボレーション環境を構築することを可能にします。 その核心には、データセット、ワークロード、ドメインに依存しないフェデレーテッドコンピューティングフレームワークとして機能し、中央集権的なデータレイクソリューションとは異なり、計算能力を分散型データセットに直接もたらします。 これにより、データは計算ノード内に保持され、承認された結果のみがコラボレーター間で共有されるため、データプライバシーとセキュリティが強化されます。
NVIDIA FLAREのアーキテクチャは、マルチプロセス、コンポーネントベースの設計に基づいており、システムはユーザーインタラクション、プロビジョニング、ランタイム実行、通信、ストレージといった明確な層に組織されています。 基盤層には通信インフラストラクチャ、メッセージングプロトコル、プライバシー保護ツール、セキュアなプラットフォーム管理が含まれ、アプリケーション層にはフェデレーションワークフローと学習アルゴリズムが含まれます。 特に、F3(FLARE Foundation Framework)およびCellNetとして知られる通信フレームワークは、FQCNアドレッシング、チャネルベースのルーティング、証明書ベースの認証によるエンドツーエンド暗号化、およびモデルの重みやデータセットの自動チャンキングによる大規模データストリーミングなどの主要な機能を提供し、すべての通信の基盤となるメッセージングインフラストラクチャを提供します。 セキュリティ面では、TLS証明書によるセキュアなプロビジョニング、イベントベースのセキュリティプラグインメカニズム、承認ポリシー制御、およびデータと結果のフィルタリングメカニズムを通じて、堅牢なセキュリティとプライバシー保護を優先しています。 このモジュール化されたコンポーネントベースの設計は、複雑な分散システムプログラミングを管理しやすいオブジェクト指向の抽象化に変換し、エンタープライズFLシステムの重要な利点となっています。
Docker、Kubernetes、SlurmによるFLワークロードのスケーリング
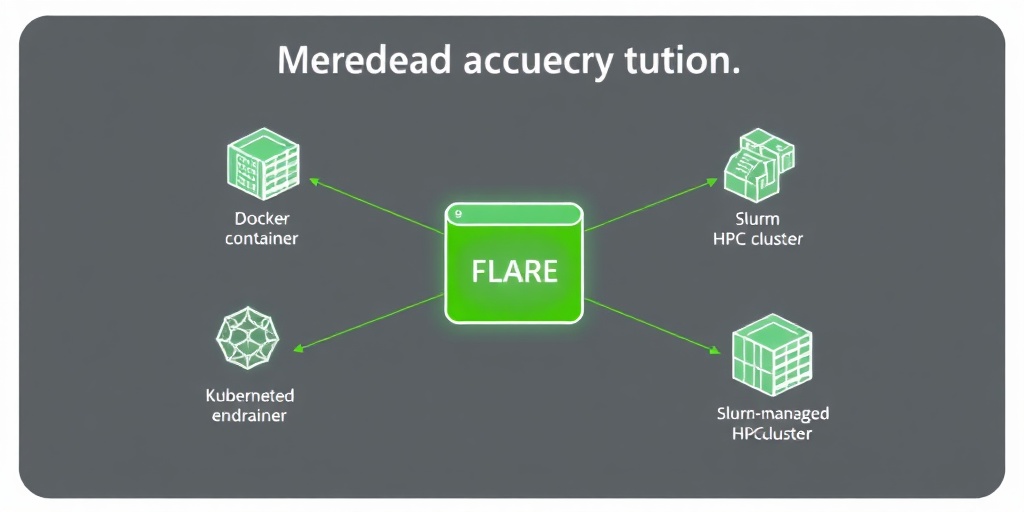
NVIDIA FLAREは、フェデレーテッドラーニングワークロードをさまざまな計算環境でスケーリングするための強力な機能を提供します。特に、Docker、Kubernetes、およびSlurmといった主要なコンテナ化およびHPC(高性能計算)オーケストレーションシステムとの統合が特徴です。NVIDIA FLARE 2.8.0では、DockerおよびKubernetesのジョブランチャーが導入され、各サイトでプロセス、Docker、またはKubernetesジョブランチャーを設定できるようになりました。 これにより、ホストベースのジョブはサブプロセスとして、Dockerベースのジョブはジョブコンテナとして、Kubernetesベースのジョブは個別のジョブポッドとして実行され、プロダクションサイトにDocker/Kubernetesの隔離とリソース処理を提供するとともに、より強力なデータ隔離のためのスタディスコープのデータマウントを提供します。
Kubernetesへの展開には、NVIDIA FLARE用のHelm Chartが提供されており、ユーザーは参照用のHelm Chartを生成して、ローカルのmicrok8s KubernetesインスタンスにNVIDIA FLAREを展開できます。 これは、既存のKubernetesクラスターにNVIDIA FLAREをデプロイしたいユーザーにとって出発点となります。 また、NVIDIA FLARE 2.9リリースでは、SlurmがDockerやKubernetesと並ぶ第一級のデプロイメントターゲットとなる予定であり、HPCクラスターにおけるFLクライアントのデプロイメントがさらに強化されます。 NVIDIAのSlinkyツールキットは、Kubernetes内でSlurmクラスターを実行し、HPCおよびクラウドネイティブGPUワークロードの統一されたリソース管理を可能にすることで、SlurmとKubernetesの統合をサポートしています。 これにより、多様なインフラストラクチャを持つ組織が、それぞれの環境の特性を活かしながら、フェデレーテッドラーニングの利点を享受できるようになります。FLAREは、既存のスタートアップキットをDockerおよびKubernetesランタイム用にパッケージ化する新しいデプロイメント準備フローも提供しており、プロビジョニングとランタイムパッケージングを独立した反復可能なステップとして処理できます。
開発効率とプライバシー保護の強化
NVIDIA FLAREは、開発者の生産性を最大化するように設計されており、開発プロセスのさまざまな段階でユーザーエクスペリエンスと研究効率を高めるツールを提供します。 特に、FLARE Client APIは、既存のML/DLスクリプトからFLへの移行をわずか数行のコード変更でシームレスに行えるようにします。 これにより、PyTorch、TensorFlow、またはPyTorch Lightningの元のトレーニングループ構造を変更することなく、ローカルのトレーニングスクリプトをフェデレーテッドクライアントに変換できます。 この「リファクタリングオーバーヘッドなし」のアプローチは、FLプロジェクトの採用を加速させる上で非常に重要です。
プライバシー保護はNVIDIA FLAREの最優先事項であり、データ隔離、コンプライアンス、およびプライバシー強化技術を第一級の要件として扱っています。 具体的には、PKI(公開鍵基盤)を用いた相互認証によりセキュアモードでの認証を行い、ルートCA、サーバー証明書、クライアント証明書、管理者証明書からなる証明書階層を採用しています。 また、差分プライバシーやセキュアアグリゲーション、ホモグラフィック暗号化など、データ保護を強化する多様なプライバシー保護アルゴリズムを提供しています。 これらの機能は、各クライアントサイトがローカルのハードウェアインフラストラクチャ、セキュリティポリシー、および独自のデータセットに対して絶対的な主権を維持することを可能にします。 加えて、NVIDIA FLAREは、TensorBoardストリーミング、MONAIとの統合、およびプロビジョニングWebダッシュボードといったエキサイティングな機能の詳細も提供し、開発者がFLアプリケーションを効率的に構築・運用するための包括的なエコシステムを構築しています。
開発者・エンジニア視点での考察
-
既存ワークフローとのシームレスな統合性: NVIDIA FLAREのClient APIは、既存のPyTorchやTensorFlowなどのローカルトレーニングスクリプトをわずか数行のコードでフェデレーテッドクライアントに変換できるため、開発者は大規模なリファクタリングなしに分散学習のメリットを享受できます。これにより、開発サイクルが短縮され、FLの導入障壁が大幅に低減されます。
-
多様な実行環境への柔軟な対応能力: Docker、Kubernetes、そして今後のSlurmサポートにより、NVIDIA FLAREはオンプレミスのHPCクラスターからクラウド環境まで、幅広いインフラストラクチャでの展開を可能にします。これは、開発者がプロジェクトの要件や組織の既存リソースに合わせて最適な実行環境を選択できるという点で、運用の柔軟性と効率性を高めます。
-
内蔵されたプライバシー・セキュリティ機能によるコンプライアンス対応の簡素化: NVIDIA FLAREが提供するPKIベースの認証、差分プライバシー、セキュアアグリゲーションなどの機能は、機密性の高いデータを扱う医療や金融などの分野において、データプライバシー規制への対応を大幅に簡素化します。開発者はセキュリティメカニズムを一から構築する手間を省き、主要なML/DLタスクに集中できます。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。