Amazon Bedrock AgentCoreを活用したインタラクティブなMCPアプリケーション構築の技術報告
Amazon Bedrock AgentCoreによるインタラクティブMCPアプリケーションのパラダイムシフト
Amazon Bedrock AgentCoreは、大規模言語モデル(LLM)の能力を最大限に引き出し、複雑な多段階会話プロセス(MCP: Multi-turn Conversational Process)を必要とするインタラクティブなアプリケーションを効率的に構築するためのマネージドサービスである。従来のLLMベースのアプリケーション開発では、ユーザーの意図理解、会話履歴の管理、外部ツールとの連携、および一貫性のある応答生成において、高度なプロンプトエンジニアリングと複雑な状態管理ロジックが開発者の負担となっていた。AgentCoreはこれらの課題を抽象化し、エージェントと呼ばれる自律的な推論コンポーネントを通じて、一連のタスクを計画、実行、および調整する能力を提供する。
AgentCoreの核となるのは、ユーザーのゴールを達成するために必要なステップを動的に推論し、適切なツールや知識ベースを呼び出すオーケストレーション機能である。これにより、開発者は詳細な会話フローを事前に定義することなく、エージェントが状況に応じて最適な行動を選択するように設計できる。このアプローチは、顧客サポート、パーソナルアシスタント、データ分析アシスタントなど、多岐にわたるインタラクティブアプリケーションの開発を加速させる。
AgentCoreのアーキテクチャと主要コンポーネントの詳細
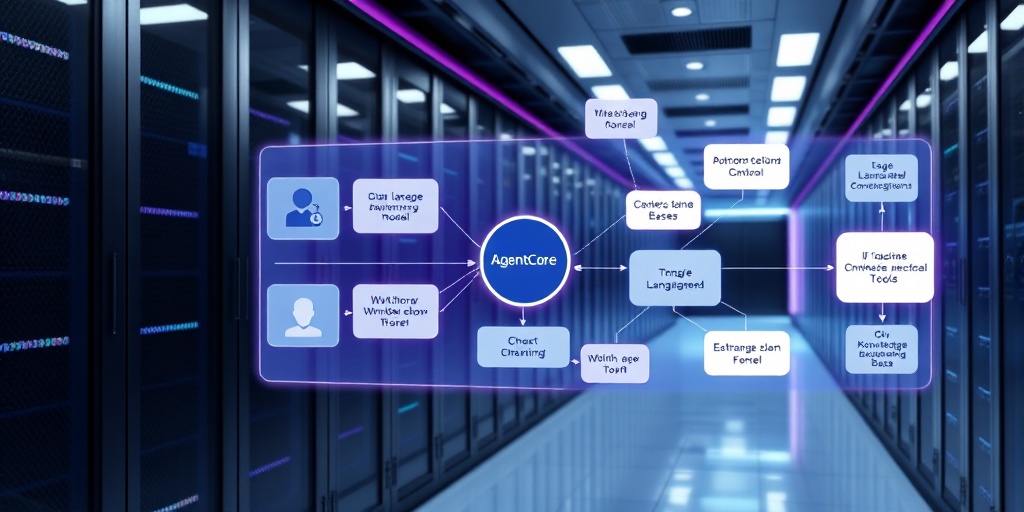
Amazon Bedrock AgentCoreは、いくつかの相互連携するコンポーネントから構成され、堅牢で拡張性の高いエージェント駆動型アプリケーションを実現する。
-
エージェント (Agent): アプリケーションの中心的な役割を担い、ユーザーの入力に基づいて目標を理解し、その達成のための計画を策定する。この計画には、基盤モデル(FM)との対話、知識ベースからの情報検索、およびツールのアクション実行が含まれる。エージェントは会話のコンテキストを維持し、過去の対話を踏まえて適切な応答や次の行動を決定する。
-
知識ベース (Knowledge Base): 独自データや企業固有のドキュメント(S3に保存されたPDF、HTMLファイルなど)を基盤モデルが利用できるようにするための機能である。このコンポーネントはRetrieval Augmented Generation (RAG) パターンを実装しており、ユーザーのクエリに関連する情報をベクトルデータベースから検索し、それを基盤モデルへのプロンプトに組み込むことで、生成される応答の正確性を高め、ハルシネーションを抑制する。このプロセスにより、基盤モデルは一般的な知識だけでなく、特定のドメイン知識に基づいた情報も提供できるようになる。
-
ツールとアクショングループ (Tools and Action Groups): エージェントが外部システムと連携するための手段である。開発者はLambda関数としてカスタムロジックを実装し、OpenAPIスキーマを通じてその機能を記述する。OpenAPIスキーマは、ツールの機能、入力パラメータ、および期待される出力を明確に定義し、エージェントが適切なタイミングでツールを選択し、正確な引数で呼び出すことを可能にする。例えば、顧客データベースの検索、注文状況の確認、チケットの発行といった具体的なアクションをツールとして定義できる。エージェントは、計画フェーズでユーザーの意図に基づいて最適なツールを動的に選択し、実行する。
-
オーケストレーション: エージェントの内部推論エンジンであり、複雑なタスクを小さなサブタスクに分解し、それぞれのサブタスクに対して最適なFM、知識ベース、またはツールを選択し、実行順序を決定する。このオーケストレーション層は、会話全体の流れを管理し、エラー処理や再試行ロジックも組み込むことで、アプリケーションの堅牢性を高める。
開発ワークフローの最適化と実践的実装戦略
AgentCoreを利用することで、インタラクティブなアプリケーション開発のワークフローは大幅に最適化される。開発者は、複雑なプロンプトチェーンや状態管理ロジックを手動で実装する代わりに、エージェントの目標、利用可能なツール、および知識ベースの設計に注力できる。
実践的な実装戦略としては、まずシンプルなアクションからツールを定義し、OpenAPIスキーマを通じて明確なインターフェースを確立することが推奨される。各ツールは単一の明確な目的を持つように設計することで、エージェントがツールの選択と実行をより正確に行えるようになる。Lambda関数を用いることで、ツールのロジックを柔軟に実装し、既存のAWSサービスや外部APIと容易に統合できる。
また、知識ベースの構築においては、高品質なデータソースの選択と、適切なチャンキングおよび埋め込み戦略が重要となる。検索の精度は、基盤モデルが生成する応答の質に直結するため、データの準備段階で十分な検討が必要である。AgentCoreのテストコンソールを活用することで、エージェントの動作、ツール呼び出し、および応答生成のプロセスをインタラクティブにデバッグし、迅速なイテレーションが可能となる。これにより、開発者はエージェントのパフォーマンスを継続的に改善し、ユーザーエクスペリエンスを最適化できる。
開発者・エンジニア視点での考察
-
複雑な対話フローの抽象化による開発効率の向上: AgentCoreは、多段階の会話におけるコンテキスト維持、状態管理、および複雑なプロンプトチェーンの実装といった煩雑なタスクをエージェントに委ねることで、開発者がビジネスロジックと外部ツール定義に集中できる環境を提供する。これにより、高度な対話型アプリケーションの開発期間が大幅に短縮され、市場投入までの時間を早めることが可能となる。
-
RAGとツール利用のシームレスな統合による機能拡張性: AgentCoreが提供する知識ベース(RAG)とカスタムツール(Lambda + OpenAPI)の統合は、基盤モデルの能力を飛躍的に拡張する。開発者は、既存の企業データやリアルタイムAPIをエージェントの意思決定プロセスに組み込むことで、単なる情報提供に留まらない、パーソナライズされ、かつ具体的なアクションを実行できるインテリジェントなアプリケーションを構築できる。
-
モジュール化されたエージェント設計による保守性と再利用性の確保: アクションを個別のツール(Lambda関数とOpenAPIスキーマ)として定義し、知識ベースを独立したコンポーネントとして扱うAgentCoreの設計は、エージェントアプリケーションのモジュール化を促進する。これにより、各コンポーネントの独立した開発、テスト、デプロイが可能となり、アプリケーション全体の保守性が向上するだけでなく、共通のツールや知識ベースを異なるエージェント間で再利用できるため、開発リソースの効率化が図れる。
Source / 元記事
この記事について
この記事は、公開されているニュース、論文、公式発表、RSSフィードなどをもとに、AIが要約・補足調査・考察を行って作成しています。
元記事の完全な翻訳・逐語的な要約ではなく、AIによる背景説明や開発者向けの考察を含みます。
重要な技術仕様・価格・提供状況などは、必ず元記事または公式情報をご確認ください。